
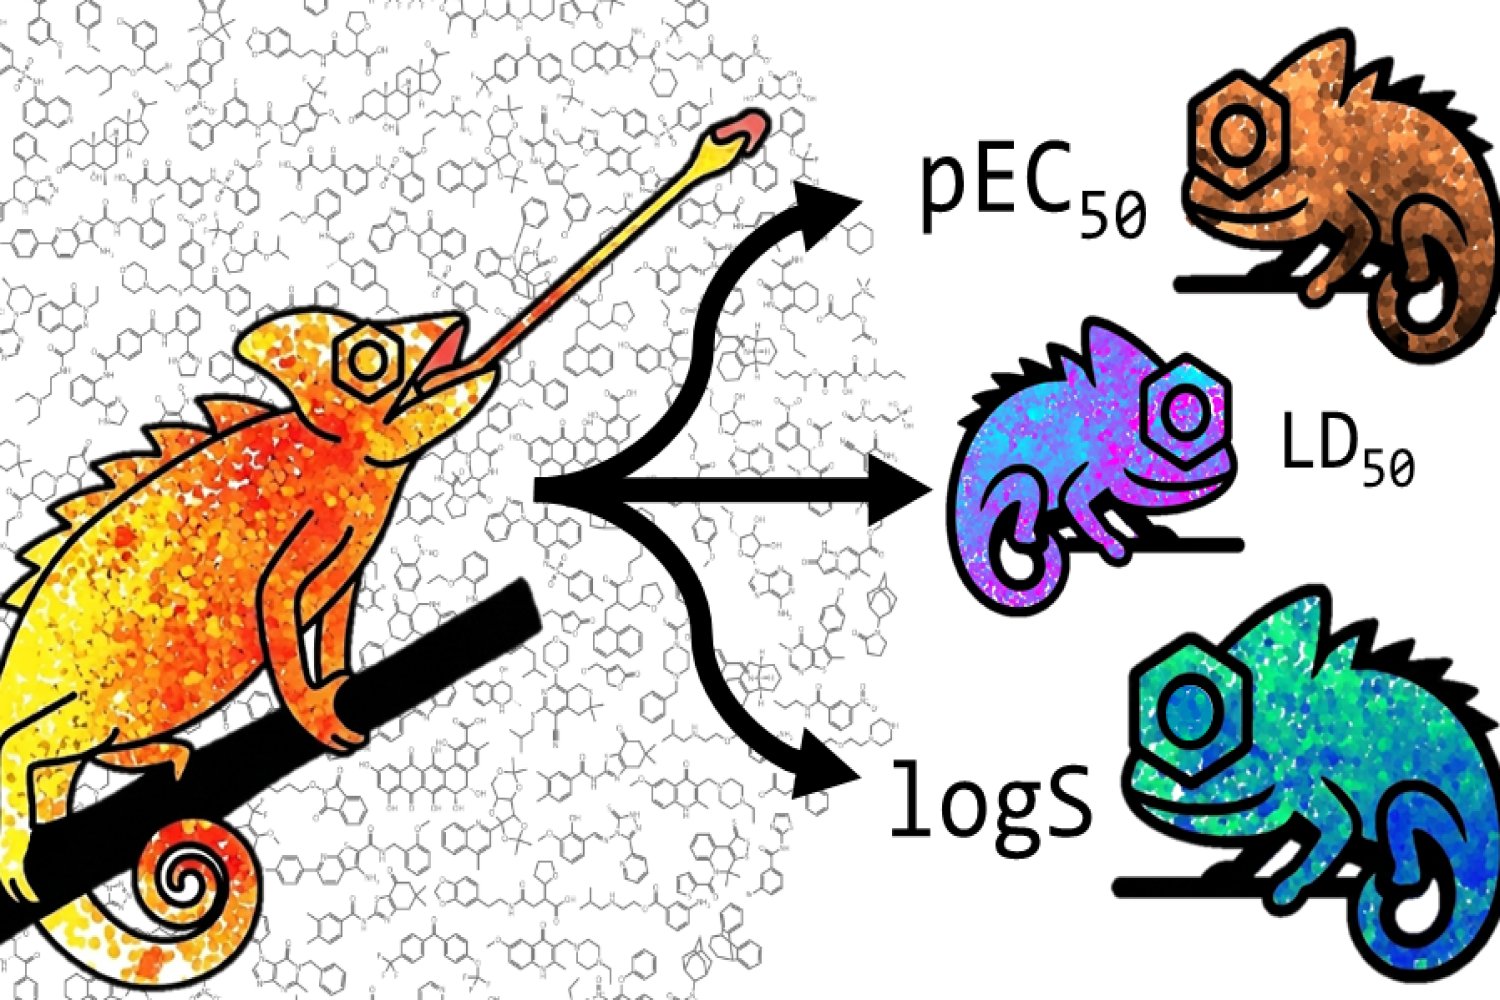
特定の用途のための新しい分子の発見は、新薬を探している製薬会社であろうと、特定の特性を持つ新材料を探しているエレクトロニクスまたはエネルギー会社であろうと、さまざまな業界の進歩の主要な原動力です。しかし、材料が示す無数の異なる特性や反応に関して、特定の化合物がどのように動作するかを完全に予測する方法はまだないため、これは主に試行錯誤のプロセスでもあります。
最近の進歩は、人工知能と機械学習を使用して、物理的原理に基づいた面倒な計算を補足または高速化することで、どの化合物が合成およびテストする価値があるかについての初期の指針を少なくとも提供できるようになりました。今回、MITで開発された新しい方法は、最近発見された潜在的な薬剤の細胞標的に対するリガンド親和性など、技術的に関連する特性に関するデータがほとんどない場合、このアプローチが検討する価値がある可能性のある分子の分野を絞り込む他の既存の方法よりも優れていることを示しています。
この研究結果は、MIT大学院生のアクシャット・シリッシュ・ザルテ氏、26年卒業のジャクソン・バーンズ博士、研究科学者のチャールズ・アブリュー氏、ウィリアム・グリーン教授、化学会社BASFの研究者3名による論文で、Journal of Chemical Information and Modelingの9月14日号に報告された。
この論文の以前のバージョンは昨年からオンラインで公開されており、チームが開発した CheMeleon と呼ばれるオープンソース モデルは、すでにいくつかの製薬会社で定期的に使用されています。 CheMeleon は、やはり MIT の Green グループによって開発および保守されているオープンソースの機械学習パッケージである ChemProp を使用して構築されており、誰でも ChemProp を通じて CheMeleon をダウンロードし、自分の目的に合わせて微調整することができます。
今年の初めに、これまで合成されていなかったさまざまな新しい分子の特性を予測するコンテストが OpenADMET によって開催された、とホイト ホッテル化学工学教授のグリーン氏は言います。 「それは大きなコンテストで、たくさんの人が参加しました」と彼は言います。受賞者が発表されたとき、上位 20 件のエントリーのうち 9 件がプロセスで CheMeleon を使用していたことが判明しました。 「その後、製薬会社からこの件についてあらゆる種類の問い合わせを受け始めましたが、私たちの論文は提出されたばかりで、まだ査読も何もされていませんでした。」
論文がその審査プロセスを経ている間に、その影響力はすでに広がっていました。少なくとも 1 つの製薬会社は、どの分子を追求するかを最初に決定する際に、「従業員全員にメッセージを送り、『特性をモデル化するときは常に CheMeleon から始めてください、それが当社の新しい会社方針です』と伝えた」とグリーン氏は述べています。
CheMeleon の鍵は、100 万の異なる分子に関する詳細なデータを使用して機械学習モデルを事前トレーニングすることで、特定の分子の構造と、数十年にわたって化学者によって開発された約 1,600 個の記述子のカタログに対してその分子がどのように動作するかの相関関係を学習できるようにすることでした。その後、CheMeleon を微調整して、溶解度や粘度などのよく知られた特性から、特定のタンパク質や酵素との生物活性や反応性などのより難解な特性まで予測できます。
これら 100 万個の分子は、原子が結合する無数の方法のうちのほんの一部にすぎませんが、これらの分子は十分な例を提供するため、AI システムがこれらの分子についてトレーニングされると、独自の多くの基礎的なパターンと関係を解明し、提示された新しい未知の分子にそれらを適用することができます。
「今日の深層学習モデルのほとんどは、従来の方法よりも多くのデータを必要とします」と Zalte 氏は言います。成功したモデルの中には、化学雑誌に掲載された文献からの広範なデータを使用しているものもあると彼は言います。 「私たちは文献をまったく見ません。ただ、特に分子量や酸素の数など、大量の分子記述子を計算するだけです。」次に、それらの記述子を予測することで、事前トレーニング タスクの基礎が形成されます。
CheMeleon は、事前トレーニングされた基礎モデルです。 ChatGPT や Claide などのよく知られた言語の基礎モデル (基本的にインターネットから大量の情報を供給して開発される) からインスピレーションを得た CheMeleon は、米国国立衛生研究所が管理する無料で利用できる大規模な化学情報データベースである PubChem からの 100 万個の分子の分子記述子を使用します。
一方、従来の専門家主導モデルでは、その分野の専門家がその主題に関する詳細な知識を手動で入力します。これらの古典的なモデルを開発する際、人々は例えば溶解度などの特定の関心のある特性が、「分子量や存在する酸素の数、あるいは分子の枝分かれやかさの程度など」同じ分子の特定の記述子に関連している可能性があることを実験から知っている、と彼は言う。
このチームのアプローチでは、既存のニューラル ネットワーク アーキテクチャから始めて、基礎となる原理を学習するようにトレーニングできます。 「私たちはこれを特定の特性に合わせてトレーニングしているのではなく、ある程度の化学レベルを理解する一般的なモデルとしてトレーニングしているので、関心のあるタスクのためにほんの数個のデータポイントを使って微調整したとしても、それでもある程度の優れたパフォーマンスを得ることができます。」と彼は言います。それは、このモデルが「すべてを最初から学習する必要がない」という事実のおかげです。
その有用性を検証するために、「私たちのモデルを、世の中にある他の基礎モデルと比較するだけでなく、専門家が設計した原理を活用した古典的なモデルとも比較しました」とザルテ氏は言います。 58 のテスト ケースにわたってそのパフォーマンスを比較すると、「私たちのモデルがトップであることが分かりました。」
Green 氏はさらに、「CheMeleon 基礎モデルは、新しい分子の特性を正確に予測するために実験的にテストする必要がある分子の数を大幅に減らします。多数の分子の合成とテストには時間がかかり、コストがかかるため、これは大きな利点です。」と付け加えました。
チームには、MIT メンバーのほかに、ドイツの BASF SE の研究者であるヨッヘン・ジーク、クリスチャン・フェルドマン、ミリアム・マテアも含まれていました。この研究は、米国エネルギー省および MathWorks からのフェローシップ支援とともに、Machine Learning for Pharmaceutical Discovery and Synthesis コンソーシアムによって支援されました。







Leave a Reply